AI · Agentic Systems
De ChatGPT a agentes: qué necesitas entender para empezar hoy
Modelos, proveedores, APIs, suscripciones y harnesses pueden hacer que empezar con agentes parezca más complicado de lo que es. Este es el mapa que me habría gustado tener cuando empecé a probarlos.
ChatGPT ya no necesita demasiada presentación. El salto empieza a parecer bastante mayor cuando sales del chat y ves a alguien abrir una terminal, lanzar Codex, Claude Code u OpenCode y dejar que el modelo trabaje sobre un proyecto real. A partir de ahí aparecen términos como modelos, providers, APIs, MCP, skills o inferencia local y es fácil pensar que para empezar hace falta entender todo el ecosistema.
Yo también fui entrando así, probando modelos, harnesses, APIs y más tarde modelos locales. Con el tiempo fui entendiendo por qué dos personas pueden decir que utilizan «el mismo modelo» y tener experiencias muy distintas: el modelo es sólo una parte del sistema que lo rodea.
Este es el mapa que me habría gustado tener entonces. Está pensado para alguien que ya conoce ChatGPT y quiere empezar a utilizar agentes sin montar primero una infraestructura propia ni perseguir cada herramienta nueva que aparece.
De hablar con un chatbot a darle trabajo a un agente
Un chat ya puede resumir documentos, interpretar capturas, buscar información o ayudarte con código. La diferencia práctica aparece cuando el modelo puede trabajar directamente sobre un entorno.
Imaginemos una carpeta con cientos de archivos desordenados. Con un chatbot puedo explicar el problema y pedirle un script. Después me toca copiarlo, ejecutarlo, volver con los errores y repetir el proceso. Un agente con acceso a esa carpeta y a una terminal puede inspeccionarla, escribir el script, ejecutarlo y comprobar el resultado por sí mismo.
En desarrollo ocurre lo mismo. En vez de pegar una función y preguntar por qué falla, puedo darle acceso al repositorio y pedirle que localice el problema. El agente puede seguir referencias, leer otros archivos, ejecutar tests y validar el cambio.
La forma más simple de entenderlo es como un modelo dentro de un bucle con herramientas:
recibe contexto → decide qué hacer → utiliza una herramienta → observa el resultado → decide de nuevo.
La capacidad del modelo sigue importando, pero ahora también importan lo que puede observar y las acciones que el sistema le permite ejecutar.
Modelo, proveedor, harness y entorno
Productos como ChatGPT ocultan casi todas estas capas. En herramientas más abiertas conviene separarlas mentalmente:
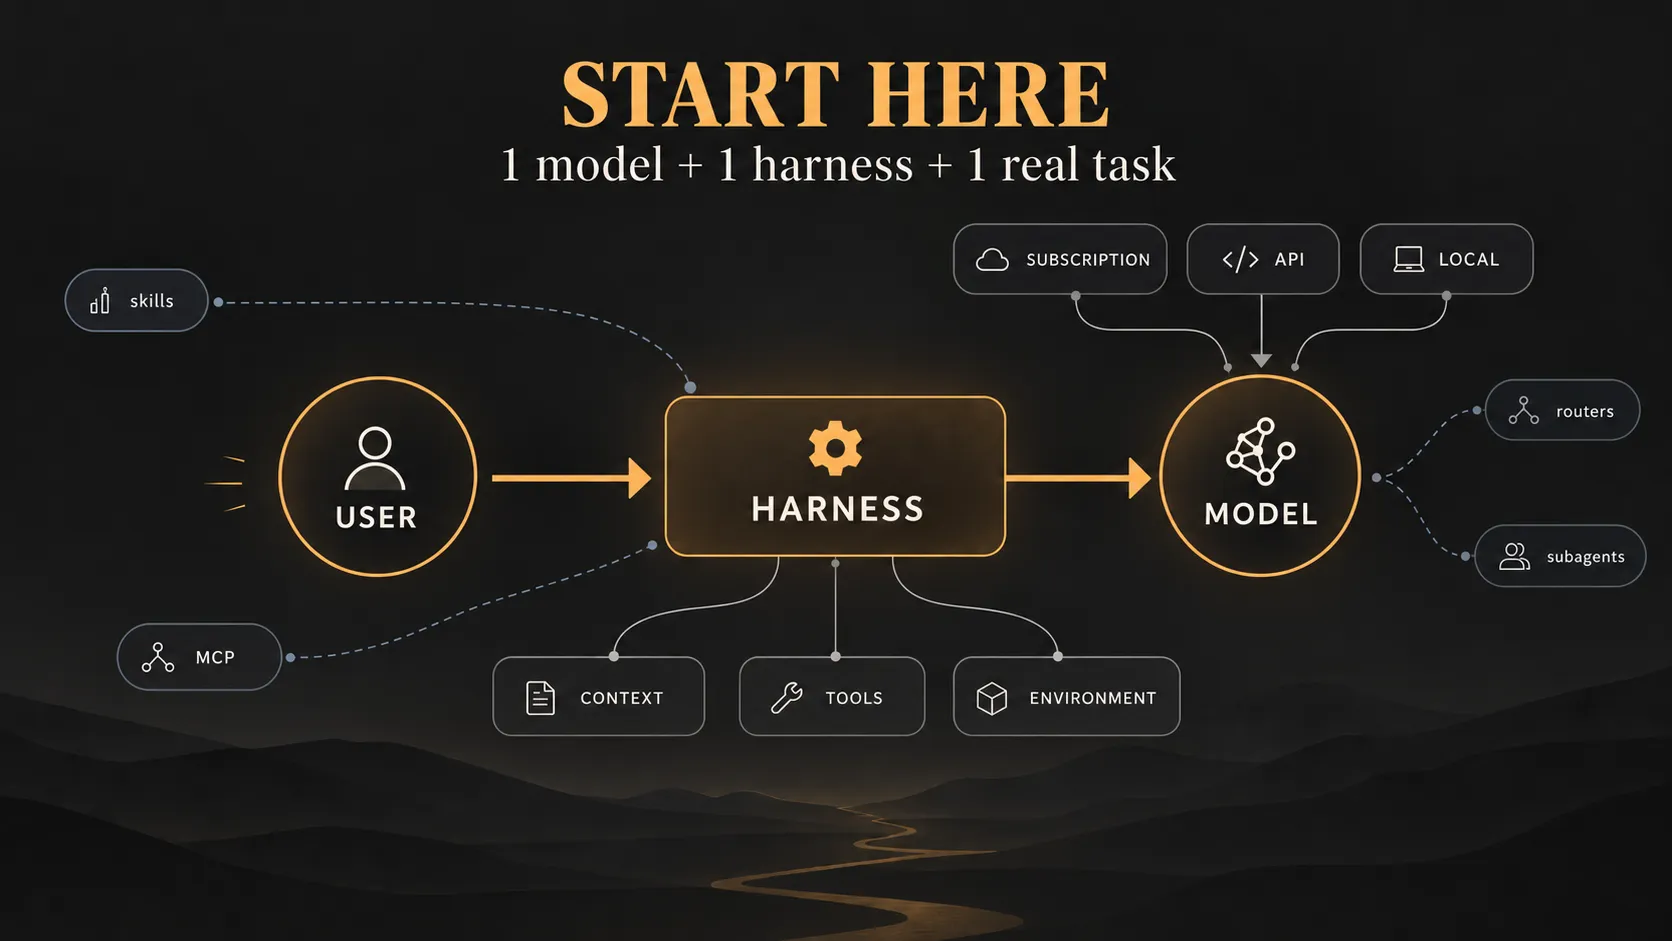
modelo → proveedor → harness → herramientas y entorno
El modelo
GPT, Claude, Gemini, Qwen o DeepSeek son familias de modelos. El modelo recibe el contexto preparado por el sistema y genera la siguiente salida, que puede ser texto, código o una solicitud para utilizar una herramienta.
A grandes rasgos, hoy conviven los modelos propietarios de compañías como OpenAI, Anthropic o Google con un ecosistema open-weight donde encontramos Qwen, DeepSeek, GLM, Kimi y otros. En ambos grupos hay modelos capaces de programar, razonar y utilizar herramientas. Esa distinción ayuda a orientarse, pero no decide por sí sola qué modelo encaja mejor en un trabajo concreto.
Para este mapa tampoco hace falta entrar en parámetros o arquitectura. Lo importante es recordar que el modelo recibe lo que el sistema ha puesto en su contexto y genera el siguiente paso. Todo lo que ocurre alrededor de esa llamada pertenece a otras capas.
El proveedor
Quien crea un modelo y quien lo ejecuta para ti no tienen por qué ser la misma empresa. Un modelo puede servirse desde distintos proveedores y cambiar bastante la experiencia por velocidad, disponibilidad, características o precio.
OpenRouter hace esta separación especialmente visible porque ofrece muchos modelos y proveedores detrás de una misma API. Para un mismo modelo puedes encontrar diferencias de latencia, throughput, disponibilidad o soporte de determinadas funciones. Es una buena forma de entender que decir «uso este modelo» todavía deja fuera una parte importante de cómo lo estás utilizando.
El harness
Codex, Claude Code y OpenCode son ejemplos de harnesses. La forma que me resulta más útil de pensarlo es sencilla: es el software que pone al modelo a trabajar.
El harness prepara el contexto, expone las herramientas disponibles, ejecuta las acciones que solicita el modelo y devuelve sus resultados al siguiente paso del loop. También puede gestionar permisos, historial y compactación de la sesión. Esa capa explica por qué el mismo modelo puede comportarse de forma bastante distinta en dos agentes.
Un stack integrado como GPT con Codex o Claude con Claude Code puede optimizar varias capas a la vez. Un harness abierto como OpenCode permite mantener un workflow parecido mientras cambias de modelo o proveedor. También cambia la interfaz: hay quien prefiere una TUI y quien trabaja mejor desde una aplicación con sesiones y diffs visibles. Por eso con el tiempo dejé de preguntar sólo «¿qué modelo estás usando?» y empecé a preguntar también «¿dónde lo estás usando?».
Suscripción, API o local
La siguiente decisión es cómo acceder al modelo. Para empezar, yo reduciría las opciones a tres: suscripción, API o ejecución local.
Suscripción
Una suscripción suele ser la forma más cómoda de experimentar porque el coste es predecible. Cuando estás aprendiendo es fácil definir mal una tarea y descubrir después que el agente ha leído medio repositorio para nada, o simplemente pasar una tarde probando distintos workflows. Con una cuota fija puedes cometer esos errores sin convertir cada prueba en una factura.
Sigues teniendo límites y reglas de uso. Una suscripción tampoco es una API ilimitada, pero para una primera experiencia me parece la vía más sencilla para descubrir si realmente te resulta útil trabajar con agentes.
API
Con una API pagas normalmente por el uso del modelo. La unidad que vas a ver constantemente son los tokens: hay tokens que envías y tokens que genera el modelo. Además, una conversación o sesión larga puede volver a procesar instrucciones, historial y resultados anteriores.
En un agente esto importa especialmente porque una petición del usuario puede desencadenar muchas inferencias. El modelo lee contexto, pide una herramienta, recibe el resultado y vuelve a decidir. Un run largo puede acumular bastante más consumo que el mensaje que lo inició.
La API tiene sentido cuando quieres integrar modelos en una aplicación, automatizar tareas desde CI o un backend, o necesitas más control sobre datos, gasto y despliegue. Como mapa inicial, me quedo con esta diferencia: una suscripción está pensada principalmente para que tú utilices un producto. Una API está pensada para que software consuma un servicio.
Si quieres probar muchos modelos con una sola integración, un router como OpenRouter resulta especialmente cómodo.
Local
La tercera opción es ejecutar el modelo en tu propio hardware con un runtime como Ollama, LM Studio o llama.cpp. Ganas control sobre el runtime y los datos que salen de tu entorno, pero introduces también los problemas de memoria y rendimiento propios de la inferencia local.
En mi caso, conseguir una experiencia que me convenciese con un Qwen de 27B y una RTX 5070 Ti de 16 GB implicó probar cuantizaciones, ajustar la KV cache y medir el rendimiento antes siquiera de empezar la prueba agentic. Lo cuento con más detalle en el artículo sobre Qwen3.8-27B con OpenCode.
Esa fricción tenía sentido porque también quería aprender inferencia local. Si el objetivo es aprender agentes, empezaría por el camino que menos te distraiga de la tarea.
Qué probaría como primera experiencia
Empezaría con un proyecto que puedas romper y una tarea que conozcas suficientemente bien como para evaluar el resultado. Así puedes ver cómo inspecciona el entorno, qué decide tocar y cómo reacciona cuando algo falla sin estrenar el agente sobre tu repositorio más importante. Puede ser una carpeta que quieras ordenar, un pequeño proyecto personal o un bug en un repositorio que ya entiendas.
Lo importante es que la tarea obligue al agente a trabajar con el entorno y que exista una forma clara de comprobar si ha terminado. Una instrucción así suele funcionar mejor que un «mejora este proyecto»:
Revisa cómo se están generando estas páginas. Quiero eliminar esta duplicidad sin cambiar las rutas públicas. Antes de modificar nada identifica dónde se produce, y después ejecuta los tests existentes y el build.
En la práctica me funciona mejor explicar el objetivo, las restricciones y cómo validar el resultado que intentar construir un prompt enorme para cada tarea.
El contexto durante una sesión agentic
Un agente que lleva un rato trabajando ya no tiene sólo nuestro último mensaje. En el contexto puede haber instrucciones del proyecto, archivos que ha leído, definiciones de tools, resultados de comandos y parte del historial. Todo eso ocupa espacio y condiciona las siguientes decisiones.
Context engineering consiste precisamente en decidir qué información necesita el modelo en cada momento. Una parte puede estar siempre presente y otra recuperarse sólo cuando hace falta. Llenar el contexto con documentación «por si acaso» también puede empeorar la señal que recibe el modelo.
En sesiones largas aparecen problemas como la compactación o la pérdida de información relevante. Se entienden mucho mejor cuando ya has visto una sesión degradarse a medida que crece. Para profundizar en esa capa tengo una Note de Ingeniería de contexto.
Elegir modelos para tu propio workflow
El mercado cambia demasiado rápido como para convertir una clasificación de modelos en algo duradero. Los benchmarks ayudan, pero una puntuación agregada no sabe si para tu trabajo pesa más la calidad, la velocidad, el coste, el contexto, el uso de herramientas o las políticas del modelo.
Por eso prefiero hacer un pequeño eval propio: elegir dos o tres modelos que tengan sentido y darles la misma tarea real. Después comparo cuál necesita menos intervención, cuál entiende mejor el objetivo, cuánto tarda y cuánto cuesta. Para un subagente repetitivo puede ganar un modelo más barato y rápido. Para una revisión difícil quizá compense usar otro más capaz.
Ese resultado suele ser más útil que perseguir el modelo que encabeza una tabla general esa semana.
Un caso especialmente incómodo: ciberseguridad
En mi caso hay otra variable porque trabajo en seguridad ofensiva. Las políticas de seguridad del modelo pueden afectar bastante al workflow cuando la tarea incluye explotación, análisis de vulnerabilidades o acciones que fuera de un entorno autorizado serían abusivas.
OpenAI tiene Daybreak / Trusted Access for Cyber, un programa para profesionales y organizaciones de seguridad que permite reducir determinados refusals en workflows autorizados. Sus niveles de acceso cubren desde trabajo defensivo hasta pentesting o validación de exploits con requisitos adicionales. Aun así, sigo encontrando sesiones donde parte de la fricción consiste en dejar claro el contexto del trabajo.
En otras pruebas, modelos como GLM o DeepSeek han sido suficientemente capaces para la tarea y me han dado una experiencia más directa. Para mí eso convierte las políticas del modelo en otro criterio práctico de selección junto a capacidad, velocidad y coste.
Lo que yo recomendaría ahora mismo
Esta parte caducará rápido, así que la dejaría explícitamente como snapshot de octubre de 2026.
| Si quieres… | Yo empezaría con… | Por qué |
|---|---|---|
| La experiencia más integrada | ChatGPT + Codex | Chat y agente dentro de un ecosistema muy integrado. |
| Claude y un agente de terminal | Claude Pro + Claude Code | Una vía directa para trabajar con Claude como agente. |
| Probar varios modelos | OpenCode + Go | Harness abierto con una selección cambiante de modelos. |
| Experimentar con APIs y providers | OpenRouter | Una sola API para comparar modelos y proveedores. |
| Aprender inferencia local | Ollama / LM Studio + modelo local | Más control, a cambio de gestionar tú el hardware y el runtime. |
Para una primera experiencia general, yo probablemente escogería ChatGPT + Codex porque me encaja bien la separación entre pensar y ejecutar. Puedo utilizar el chat para discutir una idea, investigar y afinar requisitos, y pasar a Codex cuando toca trabajar sobre archivos o un repositorio. Ese patrón se ha convertido en mi forma habitual de utilizar estas herramientas: debatir en el chat → implementar con el agente.
Empezar con el mínimo setup útil
Es fácil dedicar más tiempo a preparar el agente que a utilizarlo. Para mí el punto de partida debería ser un modelo, un harness, un proyecto que puedas romper y una tarea real.
A partir de ahí añadiría piezas cuando resuelvan un problema concreto. Si repites un procedimiento, una skill puede tener sentido. Si necesitas conectar una herramienta externa, quizá llegue el momento de MCP. Si quieres cambiar continuamente de modelo o proveedor, un router empieza a aportar valor. Si el objetivo pasa a ser privacidad o aprender inferencia, entonces tiene sentido asumir la complejidad de un modelo local.
Ese orden me resulta mucho más útil que empezar copiando una arquitectura compleja antes de saber qué necesito.